Modern Data Stack en local : une démonstration avec RustFS et DuckDB#
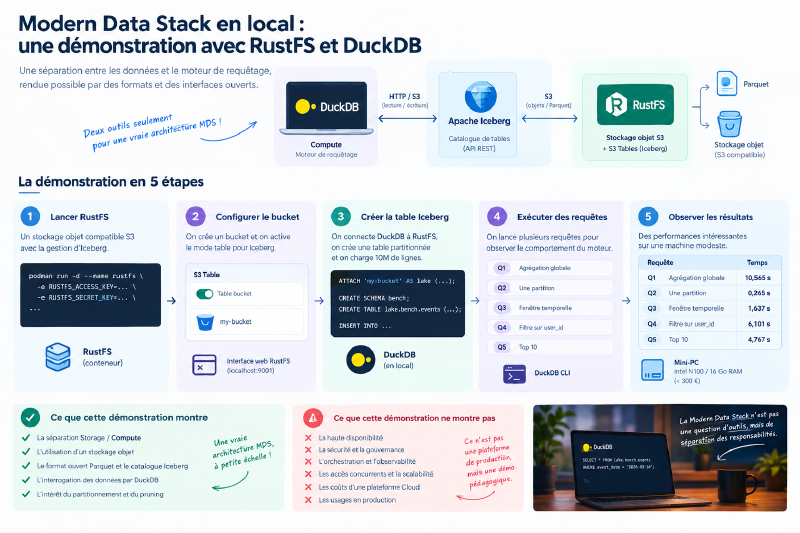
Dans mon précédent article, je revenais sur les origines de la Modern Data Stack et sur un principe qui me semble fondamental : le découplage entre le stockage et le compute.
Mais une question reste intéressante :
À quoi ressemble concrètement ce découplage ?
Pour le voir, pas besoin de déployer un cluster Kubernetes ou de souscrire à une plateforme Cloud.
Nous allons construire une Modern Data Stack minimale, directement sur un poste de travail, avec seulement deux outils :
RustFS + DuckDB
L’objectif n’est évidemment pas de construire une plateforme de production.
L’objectif est de rendre les concepts de la Modern Data Stack concrets et manipulables.
Une Modern Data Stack minimale#
Pour cette démonstration, nous allons nous concentrer sur les éléments fondamentaux :
- Apache Iceberg : le format de table, qui décrit notamment les métadonnées, snapshots, manifests et fichiers constituant la table.
- Iceberg REST Catalog : le service de catalogue utilisé par les moteurs pour découvrir et gérer les tables Iceberg.
- RustFS : fournit ici à la fois le stockage objet compatible S3 et le service Iceberg REST Catalog.
- Parquet : le format des fichiers de données.
- DuckDB : le moteur de calcul utilisé dans cette démonstration.
On obtient donc une architecture très simple :
                    ┌──────────────────┐
                    │      DuckDB      │
                    │      Compute     │
                    └────────┬─────────┘
                             │
                       REST Catalog
                             │
                    ┌────────▼─────────┐
                    │      RustFS      │
                    │                  │
                    │ Iceberg Catalog  │
                    │    + S3 Store    │
                    └────────┬─────────┘
                             │
                       Iceberg Table
                             │
                       Parquet files
Le point important n’est pas le nombre d’outils.
C’est la séparation des responsabilités.
DuckDB n’a pas besoin de gérer physiquement le stockage des données.
RustFS n’a pas besoin d’être le moteur qui exécute les requêtes analytiques.
Iceberg fournit quant à lui la couche de table qui permet au moteur de travailler avec les données stockées dans l’object storage.
C’est cette séparation que nous allons mettre en pratique.
Prérequis#
Pour cette démonstration, vous aurez besoin d’un environnement Linux.
Personnellement, j’utilise Fedora dans Windows 11 via WSL.
Pour les conteneurs, j’utilise Podman.
Si vous utilisez Docker, les commandes peuvent être adaptées facilement.
La démonstration reste volontairement simple et ne cherche pas à reproduire les problématiques d’une architecture de production.
1. Installer RustFS#
Nous allons commencer par lancer RustFS dans un conteneur :
podman run -d --name rustfs \
  -e RUSTFS_ACCESS_KEY=rustfsadmin \
  -e RUSTFS_SECRET_KEY=rustfsadmin \
  -e RUSTFS_VOLUMES=/data \
  -e RUSTFS_ADDRESS=":9000" \
  -e RUSTFS_CONSOLE_ADDRESS=":9001" \
  -e RUSTFS_CONSOLE_ENABLE=true \
  -v rustfs-data:/data \
  -p 9000:9000 \
  -p 9001:9001 \
  rustfs/rustfs:latest
Une fois le conteneur lancé, nous pouvons accéder à l’interface web de RustFS :
http://localhost:9001/
Pour cette démonstration, nous utilisons :
Utilisateur : rustfsadmin
Clé : rustfsadmin
Dans l’interface, nous créons ensuite un bucket nommé :
my-bucket
Puis nous activons le Table Bucket dans la partie S3 Table.
Nous avons maintenant notre couche de stockage.
2. Créer notre table Iceberg avec DuckDB#
Nous allons maintenant utiliser DuckDB comme moteur analytique.
L’objectif est de créer :
- un catalogue Iceberg nommé
lake; - un schéma
bench; - une table
events; - une partition sur
event_date; - 10 millions de lignes ;
- réparties sur 90 jours.
On lance DuckDB en ligne de commande puis on active le timer pour voir les temps d’exécution et on install la prise en charge d’Iceberg.
.timer on
INSTALL iceberg; LOAD iceberg;
INSTALL httpfs;  LOAD httpfs;
Nous allons ensuite exécuter plusieurs requêtes afin d’observer le comportement du moteur.
La connexion à RustFS se fait en deux parties.
Le data plane permet à DuckDB d’accéder aux fichiers stockés dans S3 :
CREATE OR REPLACE SECRET rustfs_s3 (
    TYPE s3, KEY_ID 'rustfsadmin', SECRET 'rustfsadmin',
    ENDPOINT 'localhost:9000', URL_STYLE 'path',
    USE_SSL false, REGION 'us-east-1'
);
Le control plane permet à DuckDB d’utiliser le catalogue Iceberg :
ATTACH 'my-bucket' AS lake (
    TYPE iceberg,
    ENDPOINT 'http://localhost:9000/iceberg',
    AUTHORIZATION_TYPE sigv4,
    SIGV4_SERVICE 's3',
    SIGV4_REGION 'us-east-1',
    SECRET rustfs_s3,
    ACCESS_DELEGATION_MODE 'none',
    STAGE_CREATE_TABLES false,
    PURGE_REQUESTED false
);
Nous pouvons ensuite créer notre schéma et notre table :
CREATE SCHEMA IF NOT EXISTS lake.bench;

DROP TABLE IF EXISTS lake.bench.events;

CREATE TABLE lake.bench.events (
    user_id    VARCHAR,
    event_type VARCHAR,
    amount     DOUBLE,
    event_ts   TIMESTAMP,
    event_date DATE
) PARTITIONED BY (event_date);
3. Charger 10 millions de lignes#
Pour avoir un jeu de données suffisamment intéressant, nous allons charger 10 millions de lignes.
Les données représentent des événements utilisateurs :
user_idevent_typeamountevent_tsevent_date
Les données sont réparties sur 90 jours et la table est partitionnée par event_date.
Le chargement est réalisé par la requêtes suivante :
INSERT INTO lake.bench.events
SELECT
    'u' || (i % 500_000),
    ['click', 'view', 'purchase', 'cart'][(i % 4) + 1],
    round(random() * 100, 2),
    TIMESTAMP '2026-01-01'
        + ((floor(i / 1_000_000) * 9) + (i % 9)) * INTERVAL 1 DAY
        + (random() * 86400) * INTERVAL 1 SECOND,
    DATE '2026-01-01'
        + ((floor(i / 1_000_000) * 9) + (i % 9))::INTEGER
FROM range(10_000_000) tbl(i);
Après le chargement, nous vérifions que nous avons bien nos 10 millions de lignes :
SELECT count(*) AS total_rows
FROM lake.bench.events;
4. Quelques requêtes analytiques#
Maintenant que les données sont présentes, nous allons exécuter plusieurs types de requêtes.
Q1 — Agrégation globale#
Nous demandons une agrégation sur l’ensemble de la table :
SELECT event_type,
       count(*) AS n,
       round(sum(amount), 2) AS ca
FROM lake.bench.events
GROUP BY ALL
ORDER BY ca DESC;
Cette requête nécessite de parcourir l’ensemble des données.
Q2 — Filtre sur une partition#
Nous filtrons maintenant sur une seule journée :
SELECT count(*) AS n,
       round(sum(amount), 2) AS ca
FROM lake.bench.events
WHERE event_date = DATE '2026-02-14';
La partition par date permet au moteur de limiter les données à parcourir.
C’est le principe du partition pruning.
Q3 — Une fenêtre temporelle#
Nous élargissons ensuite la recherche à un mois :
SELECT event_type,
       count(*) AS n
FROM lake.bench.events
WHERE event_date BETWEEN DATE '2026-02-01'
                     AND DATE '2026-02-28'
GROUP BY ALL
ORDER BY n DESC;
Le moteur peut là encore exploiter la partition sur event_date.
Q4 — Filtre sur une colonne non partitionnée#
Cette fois, nous recherchons un utilisateur :
SELECT event_date,
       count(*) AS n
FROM lake.bench.events
WHERE user_id = 'u12345'
GROUP BY ALL
ORDER BY n DESC
LIMIT 5;
Cette requête recherche un user_id précis, alors que la table est partitionnée par event_date.
Le prédicat peut être poussé jusqu’au scan Parquet, mais cela ne signifie pas que DuckDB pourra éliminer efficacement les row groups.
Dans notre jeu de données, les user_id sont générés de manière cyclique. Les différentes valeurs sont donc largement mélangées dans les fichiers. Les statistiques min/max des row groups sont par conséquent peu discriminantes pour ce type de recherche.
Le résultat est un temps de lecture nettement supérieur à celui observé lorsque le prédicat porte directement sur la colonne de partition.
Q5 — Top 10#
Enfin, nous réalisons une agrégation sur une fenêtre temporelle :
SELECT user_id,
       round(sum(amount), 2) AS total
FROM lake.bench.events
WHERE event_ts >= TIMESTAMP '2026-02-01 00:00:00'
GROUP BY ALL
ORDER BY total DESC
LIMIT 10;
5. Les résultats#
Voici les temps obtenus sur ma machine :
| Requête | Temps |
|---|---|
| Q1 — Agrégation globale | 10,565 s |
| Q2 — Une partition | 0,265 s |
| Q3 — Fenêtre temporelle | 1,637 s |
Q4 — Filtre sur user_id | 6,101 s |
| Q5 — Top 10 | 4,767 s |
La machine utilisée est plutôt modeste :
Intel N100 / 16 Go de RAM
et coûte moins de 300 €.
Le résultat le plus intéressant est probablement Q2 : une requête ciblant une seule partition s’exécute en environ 265 ms, alors que l’agrégation globale nécessite plus de 10 secondes.
Cela permet de visualiser très concrètement l’intérêt du partitionnement et du pruning.
Ce que cette démonstration montre#
Cette expérience permet surtout d’illustrer plusieurs concepts de la Modern Data Stack :
1. Le stockage et le compute peuvent être séparés.
RustFS stocke les données.
DuckDB les interroge.
2. Les formats ouverts jouent un rôle important.
Parquet et Iceberg permettent aux différentes briques de communiquer sans imposer un format propriétaire unique.
3. Le moteur analytique peut être interchangeable.
Dans cette démonstration, DuckDB joue le rôle du compute.
Mais le principe architectural est justement de ne pas confondre le moteur de calcul avec le stockage des données.
4. Une architecture Data moderne n’implique pas nécessairement une infrastructure gigantesque.
Ici, tout fonctionne localement sur une seule machine.
Ce que cette démonstration ne montre pas#
Il faut évidemment garder les limites de l’expérience en tête.
Nous ne testons pas ici :
- la haute disponibilité ;
- la sécurité ;
- la gouvernance ;
- l’orchestration ;
- l’observabilité ;
- les accès concurrents ;
- la scalabilité horizontale ;
- les problématiques de production ;
- ni le coût d’une infrastructure Cloud.
Ce n’est donc pas un benchmark de plateforme Data.
Et ce n’est pas non plus une recommandation de remplacer une architecture de production par cette stack.
C’est une démonstration pédagogique du découplage Storage / Compute.
Une Modern Data Stack sur un PC ?#
Finalement, c’est peut-être la partie la plus intéressante de cette expérience.
On associe souvent la Modern Data Stack à de nombreuses briques SaaS, à des architectures Cloud et à des infrastructures complexes.
Mais si on revient aux fondamentaux, le principe peut être beaucoup plus simple :
┌─────────────────────────────────────────────┐
│                   Compute                   │
│                                             │
│                   DuckDB                    │
└──────────────────────┬──────────────────────┘
                       │
                       │ REST Catalog API
                       ▼
┌─────────────────────────────────────────────┐
│                  Catalog                    │
│                                             │
│            Iceberg REST Catalog             │
└──────────────────────┬──────────────────────┘
                       │
                       │
                       ▼
┌─────────────────────────────────────────────┐
│                Table format                 │
│                                             │
│               Apache Iceberg                │
└──────────────────────┬──────────────────────┘
                       │
                       │ references
                       ▼
┌─────────────────────────────────────────────┐
│                   Storage                   │
│                                             │
│             RustFS / S3 / Parquet           │
└─────────────────────────────────────────────┘
Avec seulement RustFS et DuckDB, nous pouvons donc expérimenter localement les mêmes grands concepts :
Stocker séparément. Décrire les données. Calculer à la demande.
C’est finalement ce que je cherchais à montrer avec cette démonstration :
La Modern Data Stack n’est pas d’abord une collection d’outils. C’est une façon de séparer les responsabilités entre les différentes briques d’une architecture Data.
Et une fois que l’on comprend ce principe, il devient beaucoup plus facile de comprendre pourquoi l’écosystème Data moderne s’est construit de cette manière.