Bonus : Un workflow Data Science sur notre stockage Iceberg avec Python & uv#
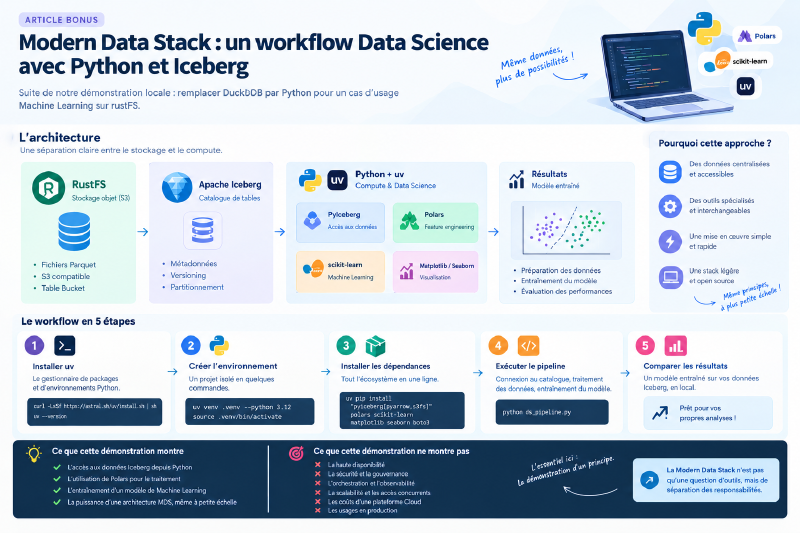
Dans les étapes précédentes, nous avons vu comment stocker nos données dans RustFS et créer un catalogue Apache Iceberg. Mais la véritable force d’avoir une architecture découplée, c’est de pouvoir basculer immédiatement vers un workflow de Data Science & Machine Learning sans altérer les données.
Ici, nous allons :
- Installer
uv, le gestionnaire de packages et d’environnements Python nouvelle génération. - Créer et configurer un environnement virtuel dédié.
- Développer un pipeline ML complet : chargement ciblé via PyIceberg, feature engineering avec Polars, et entraînement d’un modèle Scikit-learn.
1. Installation de uv et préparation de l’environnement#
uv remplace à la fois pip, pip-tools, virtualenv et même pyenv. Il permet de créer des environnements et d’installer des paquets jusqu’à 10 à 100 fois plus rapidement que pip.
Étape 1.1 : Installer uv#
Sur Linux / macOS / WSL (comme dans notre environnement de démonstration) :
curl -LsSf https://astral.sh/uv/install.sh | sh(Sur Windows PowerShell sans WSL, vous utiliseriez : powershell -c "irm [https://astral.sh/uv/install.ps1](https://astral.sh/uv/install.ps1) | iex")
Vérifiez l’installation :
uv --versionÉtape 1.2 : Créer le projet et l’environnement virtuel (venv)#
Créez un dossier pour le projet Data Science, initialisez le projet et créez l’environnement virtuel en une commande :
# Création du dossier et déplacement
mkdir iceberg-ds && cd iceberg-ds

# Création du venv avec une version spécifique de Python (ex: Python 3.12)
uv venv .venv --python 3.12
Activez l’environnement virtuel :
# Sur Linux / macOS / WSL :
source .venv/bin/activate
Étape 1.3 : Installer les dépendances avec uv#
Installez l’ensemble de la stack Data Science en une seule ligne ultra-rapide :
uv pip install "pyiceberg[pyarrow,s3fs]" polars scikit-learn matplotlib seaborn boto32. Architecture du workflow Data Science#
 ┌──────────────────┐
 │  PyIceberg / S3  │ ──> Scan intelligent (Partition Pruning par date)
 └────────┬─────────┘
          │ (PyArrow)
 ┌────────▼─────────┐
 │  Polars Dataframe│ ──> Feature Engineering vectorisé (RFM / Récence)
 └────────┬─────────┘
          │ (NumPy / SciPy)
 ┌────────▼─────────┐
 │   Scikit-Learn   │ ──> Modélisation & Scoring (RandomForest Classifier)
 └──────────────────┘
3. Pipeline Python : De la table Iceberg au Modèle ML#
Voici le script ds_pipeline.py à placer dans votre dossier :
import os

# Credentials AWS pour la signature SigV4 (boto3)
os.environ["AWS_ACCESS_KEY_ID"] = "rustfsadmin"
os.environ["AWS_SECRET_ACCESS_KEY"] = "rustfsadmin"
os.environ["AWS_DEFAULT_REGION"] = "us-east-1"

import time
import polars as pl
from pyiceberg.catalog import load_catalog

# Imports Scikit-Learn
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, roc_auc_score

# -------------------------------------------------------------------
# 1. Connexion au catalogue Iceberg dans RustFS
# -------------------------------------------------------------------
catalog = load_catalog(
    "lake",
    **{
        "type": "rest",
        "uri": "http://localhost:9000/iceberg",
        "prefix": "my-bucket",  # Nécessaire pour cibler le S3 Table Bucket
        # SigV4 pour RustFS REST
        "rest.sigv4-enabled": "true",
        "rest.signing-region": "us-east-1",
        "rest.signing-name": "s3",
        # Accès S3 Data Plane
        "s3.endpoint": "http://localhost:9000",
        "s3.access-key-id": "rustfsadmin",
        "s3.secret-access-key": "rustfsadmin",
        "s3.region": "us-east-1",
        "s3.ssl.enabled": "false",
        "s3.path-style-access": "true",
    }
)

table = catalog.load_table("bench.events")

# -------------------------------------------------------------------
# 2. Extraction des données d'entraînement (Partition Pruning)
# -------------------------------------------------------------------
print("📥 Chargement des données d'apprentissage (Février 2026)...")
start = time.time()

# Grace aux métadonnées Iceberg, seuls les fichiers Parquet de Février sont lus
arrow_scan = table.scan(
    row_filter="event_date >= '2026-02-01' AND event_date <= '2026-02-28'"
).to_arrow()

df_raw = pl.from_arrow(arrow_scan)
print(f"✅ {len(df_raw):,} événements chargés en {time.time() - start:.2f} s")

# -------------------------------------------------------------------
# 3. Feature Engineering avec Polars (Profils Utilisateurs / RFM)
# -------------------------------------------------------------------
print("\n⚙️ Calcul des features comportementales par utilisateur...")

# Date de référence pour calculer la récence
max_date = df_raw.select(pl.col("event_ts").max()).item()

features_df = (
    df_raw.group_by("user_id")
    .agg(
        # Récence (jours depuis le dernier événement)
        ((max_date - pl.col("event_ts").max()).dt.total_seconds() / 86400).alias("recency_days"),
        # Fréquence totale
        pl.len().alias("total_events"),
        # Répartition des actions (Clicks, Views, Cart, Purchase)
        pl.col("event_type").filter(pl.col("event_type") == "purchase").len().alias("count_purchase"),
        pl.col("event_type").filter(pl.col("event_type") == "cart").len().alias("count_cart"),
        pl.col("event_type").filter(pl.col("event_type") == "click").len().alias("count_click"),
        # Montants dépensés
        pl.col("amount").sum().alias("total_spent"),
        pl.col("amount").mean().alias("avg_spent"),
    )
    .with_columns(
        # Target binaire : l'utilisateur a-t-il effectué au moins un achat ?
        (pl.col("count_purchase") > 0).cast(pl.Int32).alias("has_purchased")
    )
)

print(f"📊 Dataset ML créé : {features_df.shape[0]:,} utilisateurs uniques")

# -------------------------------------------------------------------
# 4. Entraînement du modèle de Machine Learning
# -------------------------------------------------------------------
X = features_df.select([
    "recency_days",
    "total_events",
    "count_cart",
    "count_click",
    "total_spent",
    "avg_spent"
]).to_pandas()

y = features_df.select("has_purchased").to_pandas().values.ravel()

# Split Train / Test
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

print("\n🤖 Entraînement d'un RandomForest Classifier...")
clf = RandomForestClassifier(n_estimators=100, max_depth=10, random_state=42)
clf.fit(X_train, y_train)

# -------------------------------------------------------------------
# 5. Évaluation du modèle
# -------------------------------------------------------------------
y_pred = clf.predict(X_test)
y_prob = clf.predict_proba(X_test)[:, 1]

print("\n--- Performance du Modèle ---")
print(f"ROC AUC Score : {roc_auc_score(y_test, y_prob):.4f}")
print("\nClassification Report :")
print(classification_report(y_test, y_pred))

# Importance des features
importances = dict(zip(X.columns, clf.feature_importances_))
print("Importance des variables :")
for feat, imp in sorted(importances.items(), key=lambda x: x[1], reverse=True):
    print(f" - {feat:15s} : {imp*100:.2f}%")
Pour exécuter le script avec uv (sans même avoir besoin d’activer manuellement le venv si vous préférez) :
uv run python ds_pipeline.pyCe que cette approche apporte#
- Utilisation d’un autre moteur de compute : Aucune trace de DuckDB dans cette exemple, l’accès aux données via iceberg ne dépend pas du moteur de compute.
- Environnement de développement instantané : Grâce à
uv, l’initialisation du projet et le téléchargement des dépendances lourdes (PyArrow, Scikit-learn) prennent à peine quelques secondes. - Accès direct sans ETL intermédiaire : Le Data Scientist consomme directement la table Iceberg du Data Lakehouse, sans demander d’exports CSV ou de dumps de bases de données.
- Zéro duplication de stockage : Le modèle s’entraîne sur les données physiques stockées dans RustFS, exploitant l’efficacité d’Apache Arrow et de Polars pour le traitement en mémoire.