Pourquoi une Modern Data Stack : retour aux sources#
Pour comprendre la Modern Data Stack (MDS), je pense qu’il faut commencer par comprendre pourquoi nous en sommes arrivés à cette solution.
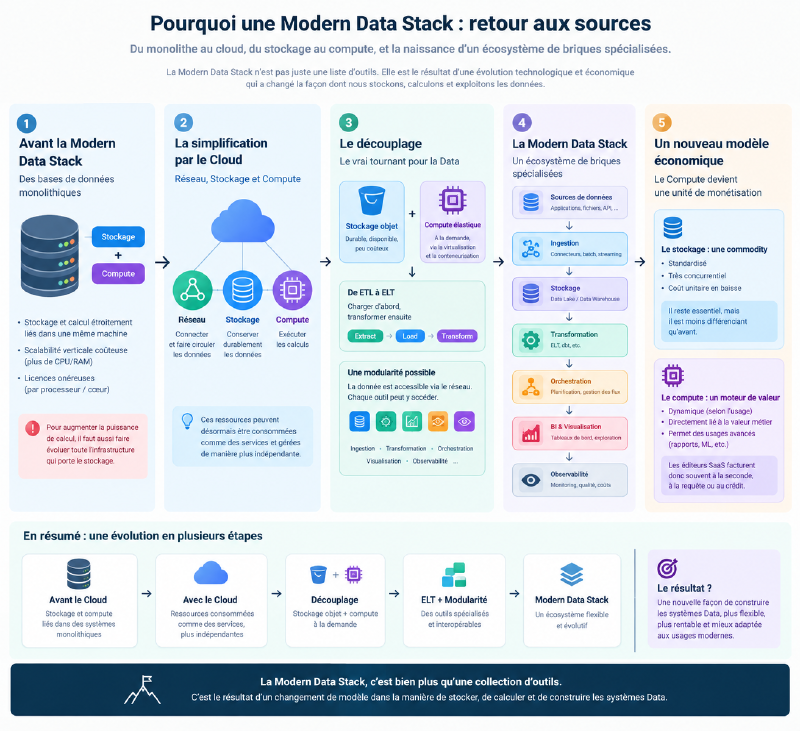
La MDS n’est pas un simple catalogue d’outils marketing. Elle est la conséquence d’une évolution profonde de l’infrastructure informatique et d’un changement d’équilibre économique.
Pour comprendre d’où vient la MDS et pourquoi elle a profondément transformé l’ingénierie des données, il faut revenir aux fondamentaux du Cloud et examiner un principe clé : le découplage du stockage et du calcul (compute).
1. Avant la Modern Data Stack#
L’époque des bases de données monolithiques#
Durant longtemps, et encore massivement aujourd’hui, une base de données repose sur un couple étroitement lié entre stockage et compute.
Nous avons donc affaire à une forme de système monolithique : les données sont stockées dans un format propriétaire sur les disques et le moteur de calcul qui permet de les exploiter est directement lié à cette infrastructure (server ou cluster).
Lorsque l’on a besoin de davantage de puissance de travail, la solution historiquement privilégiée est la scalabilité verticale : ajouter du processeur et de la RAM à une même machine.
Cette approche devient rapidement coûteuse. Plus une même machine concentre de composants, plus elle est chère, et les possibilités d’évolution sont naturellement limitées par les capacités de cette machine.
À cela pouvaient également s’ajouter les coûts de licences des bases de données commerciales, souvent calculés en fonction du nombre de processeurs ou de cœurs.
Le problème est donc relativement simple : pour augmenter la puissance de calcul, il faut également faire évoluer une infrastructure qui porte le stockage.
Cette contrainte paraît aujourd’hui assez naturelle, mais c’est précisément ce modèle que le Cloud va progressivement contribuer à remettre en question.
2. La simplification par le Cloud : Réseau, Stockage et Compute#
L’arrivée du Cloud a profondément transformé l’informatique.
Si l’on écarte une partie du jargon marketing, on peut simplifier cette transformation à travers trois briques fondamentales :
- Le Réseau : la capacité à interconnecter des composants et à déplacer des données d’un point A à un point B de manière sécurisée et à grande vitesse.
- Le Stockage : la capacité à conserver des données sous forme binaire de manière persistante, durable et hautement disponible.
- Le Compute (Calcul) : la puissance processeur - CPU, GPU et mémoire - capable d’exécuter des instructions et de transformer les données.
Ces trois briques ne résument évidemment pas à elles seules toute l’infrastructure Cloud.
Mais elles permettent de comprendre une évolution essentielle : ces ressources peuvent désormais être consommées comme des services et, surtout, être gérées de manière beaucoup plus indépendante.
On n’a plus nécessairement besoin de penser une machine comme un bloc unique contenant à la fois le stockage et la puissance de calcul.
Et c’est cette évolution qui va profondément changer la manière de construire les plateformes Data.
3. L’acte de naissance du Modern Data Stack : le découplage#
L’avènement du Cloud a accompagné une rupture technologique majeure : la généralisation du stockage objet, hautement disponible, durable et relativement peu coûteux, à l’image d’AWS S3 ou de Google Cloud Storage.
En parallèle, la virtualisation et les nouvelles formes d’abstraction de l’infrastructure ont permis d’allouer de la puissance de calcul à la demande, sans nécessairement dimensionner une machine physique unique pour supporter l’ensemble de la charge.
Pour la Data, cela change beaucoup de choses.
Le stockage peut désormais être considéré comme une couche relativement indépendante du moteur qui va effectuer les calculs.
C’est cette séparation qui constitue, à mes yeux, l’un des éléments fondamentaux permettant de comprendre la naissance du Modern Data Stack.
Cette évolution entraîne deux transformations majeures dans le monde de la Data.
Du modèle ETL au modèle ELT#
Lorsque le stockage est relativement peu coûteux et que le compute peut être mobilisé à la demande, il n’est plus toujours nécessaire de transformer la donnée avant de la charger afin d’économiser au maximum les ressources d’une base de données rigide et coûteuse.
On peut alors adopter une approche différente :
Extract → Load → Transform
On extrait les données depuis les systèmes sources, on les charge dans une couche de stockage ou un Data Warehouse, puis on utilise le compute lorsque l’on souhaite les transformer ou les analyser.
C’est le principe de l’ELT.
La logique change donc :
Avant : je transforme pour pouvoir stocker. Après : je stocke, puis je transforme lorsque j’en ai besoin.
Bien évidemment, la réalité est plus complexe et les architectures ETL n’ont pas disparu.
Mais cette nouvelle manière de travailler devient beaucoup plus simple à mettre en œuvre dans un environnement Cloud où le stockage et le compute peuvent être dissociés.
L’explosion de la modularité#
Et c’est ici que le sujet devient particulièrement intéressant.
Dès lors que la donnée réside sur une couche de stockage relativement neutre et accessible via le réseau, différents outils peuvent venir y accéder.
On n’est plus obligé de confier l’ensemble de la chaîne Data à un seul système.
On peut choisir :
- un outil pour ingérer les données ;
- un autre pour les transformer ;
- un autre pour orchestrer les traitements ;
- un autre pour les visualiser ;
- un autre pour observer et surveiller les pipelines.
C’est l’une des conditions qui ont permis l’émergence du Modern Data Stack : un écosystème modulaire composé de composants spécialisés et pouvant être assemblés en fonction des besoins.
Le changement de paradigme est important.
On passe progressivement d’une logique de plateforme monolithique à une logique de briques spécialisées.
Et cette modularité devient elle-même une valeur.
4. L’équation économique : pourquoi le Compute est devenu central dans le Data SaaS#
Le découplage du stockage et du compute n’a pas seulement transformé la manière de construire les architectures Data.
Il a également changé la manière dont les éditeurs de logiciels peuvent monétiser leurs services.
Pourquoi retrouve-t-on aujourd’hui autant de modèles tarifaires basés sur la consommation ?
Une partie de la réponse se trouve dans la différence entre le stockage et le calcul.
Le stockage est devenu une commodity#
Le stockage Cloud est devenu une ressource extrêmement standardisée et fortement concurrentielle.
Son coût unitaire a considérablement diminué au fil du temps et plusieurs fournisseurs proposent aujourd’hui des services de stockage comparables.
Le stockage reste évidemment essentiel - sans lui, pas de Data.
Mais il est devenu beaucoup moins différenciant qu’il ne pouvait l’être dans les architectures traditionnelles.
La valeur ne se trouve donc plus uniquement dans le fait de conserver la donnée.
Elle se trouve également dans la capacité à l’exploiter.
Le Compute est le véritable moteur de valeur#
À l’inverse du stockage, le besoin en calcul est dynamique.
Un téraoctet de données peut rester quasiment inutilisé pendant un mois.
Mais ce même téraoctet peut également être :
- interrogé par des milliers de requêtes ;
- utilisé par des pipelines de transformation ;
- exploité par des tableaux de bord interactifs ;
- analysé par des modèles de Machine Learning.
La quantité de données stockées ne nous dit donc pas nécessairement combien de calcul sera nécessaire pour l’exploiter.
Et c’est là que le modèle économique devient intéressant pour les éditeurs.
Les plateformes Data modernes investissent dans des moteurs capables de paralléliser les traitements, d’optimiser les requêtes, de gérer efficacement la mémoire et d’allouer les ressources nécessaires en fonction de la charge.
La valeur perçue réside alors dans plusieurs choses :
la puissance de calcul, la vitesse d’exécution, l’optimisation et la simplicité d’utilisation.
En facturant le calcul à la seconde, à la requête, au crédit ou selon différents modèles de consommation, les éditeurs peuvent ainsi aligner une partie de leur modèle économique sur l’usage réel de leur plateforme.
Plus une plateforme est utilisée pour transformer et analyser les données, plus le besoin en compute peut augmenter.
Conclusion#
Si l’on prend un peu de recul, l’histoire de la Modern Data Stack peut donc se résumer assez simplement.
Avant le Cloud, stockage et compute étaient fortement liés dans des systèmes relativement monolithiques.
Avec le Cloud, ces ressources ont progressivement pu être consommées et dimensionnées de manière plus indépendante.
Le stockage objet a permis de conserver de grandes quantités de données à relativement faible coût, tandis que le compute pouvait être mobilisé en fonction des besoins.
Cette séparation a favorisé l’ELT, puis une plus grande modularité des architectures Data.
Et cette modularité a permis l’émergence d’un nouvel écosystème d’outils spécialisés : la Modern Data Stack.
Mais cette histoire ne s’arrête pas à la technique.
Le découplage du stockage et du compute a également créé un nouveau terrain économique : celui d’une infrastructure où une partie importante de la valeur et de la facturation peut être directement liée à la consommation de calcul.
C’est peut-être finalement la meilleure manière de comprendre la Modern Data Stack :
Ce n’est pas seulement une collection de nouveaux outils Data. C’est le résultat d’un changement de modèle dans la manière de stocker, de calculer et de construire les systèmes Data.