IA Locale & Souveraine #2 : LLM en Python sans Ollama — llama.cpp brut#
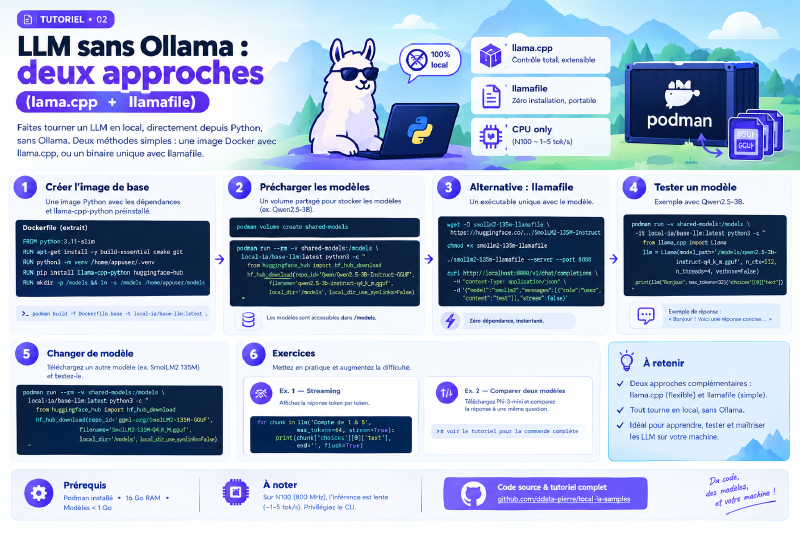
Ollama c’est pratique. Mais parfois vous voulez juste from llama_cpp import Llama dans votre pipeline Python, sans serveur intermédiaire, sans API REST, sans couche en plus. Ce tuto montre comment.
Ce que fait ce tuto (en 15 min)#
- Construit une image de base unique (
local-ia/base-llm) avecllama-cpp-pythoncompilé (OpenBLAS activé) + venv isolé — build une seule fois pour tous les tutos 2 à 6. - Crée un volume
shared-modelsmonté sur/models: le modèle GGUF (Qwen2.5-3B-Instruct Q4_K_M, 1,8 Go) est téléchargé une seule fois, partagé par tous les conteneurs dérivés. - Deux approches au choix :
- Image de base + llama.cpp : contrôle total, extensible, volume partagé.
- llamafile : binaire unique portable (Cosmopolitan Libc), zéro build, zéro dépendance — idéal pour tester vite.
- Test non-interactif, streaming token par token, changement de modèle à la volée (SmolLM2, Phi-3-mini…).
Pourquoi cette approche ?#
| Critère | Ollama (tuto 1) | llama.cpp direct (ce tuto) |
|---|---|---|
| Intégration Python | Via client HTTP / SDK | Natif, in-process |
| Overhead | Serveur + API | Zéro (appel fonction) |
| Personnalisation | Modelfile | Code Python pur |
| Poids déploiement | Image + serveur | Image de base partagée |
Pour qui ?#
Équipes Data/ML qui intègrent de l’inférence LLM dans leurs pipelines Python existants (Airflow, Prefect, scripts ETL, notebooks) — sans ajouter de service réseau à maintenir.
Accès au code complet#
👉 Tutoriel pas à pas (GitHub) : 02-raw-llama/docs/tutoriel.md
Prochain épisode : on utilise ce socle pour classifier des tickets d’incidents — département, frustration, urgence — en JSON structuré, zéro hallucination.