IA Locale & Souveraine 1 : Préparer WSL2 + Podman et lancer son premier LLM#
Introduction#
Dans nos architectures Modern Data Stack locales, la confidentialité et la maîtrise des coûts de calcul sont des priorités absolues. L’IA générative n’échappe pas à cette règle : envoyer des données métiers sensibles vers des API SaaS tierces pose des questions d’éthique, de conformité (RGPD) et de dépendance budgétaire.
Dans cette série de tutoriels, nous allons construire pas à pas une stack d’IA locale, légère et entièrement conteneurisée, capable de tourner sur un poste de developpeur ou un serveur local (type mini PC Intel N100 ou workstation).
Ce premier volet est dédié à la mise en place du socle système et à la prise en main de notre premier LLM.
Objectifs de ce tutoriel#
- Installer et configurer un environnement isolable et reproductible basé sur WSL2 (Ubuntu) et Podman en mode rootless.
- Comprendre le format GGUF et les quantifications (ex. Q4_K_M, Q8) pour faire tourner des LLM performants sur du matériel grand public (CPU + RAM).
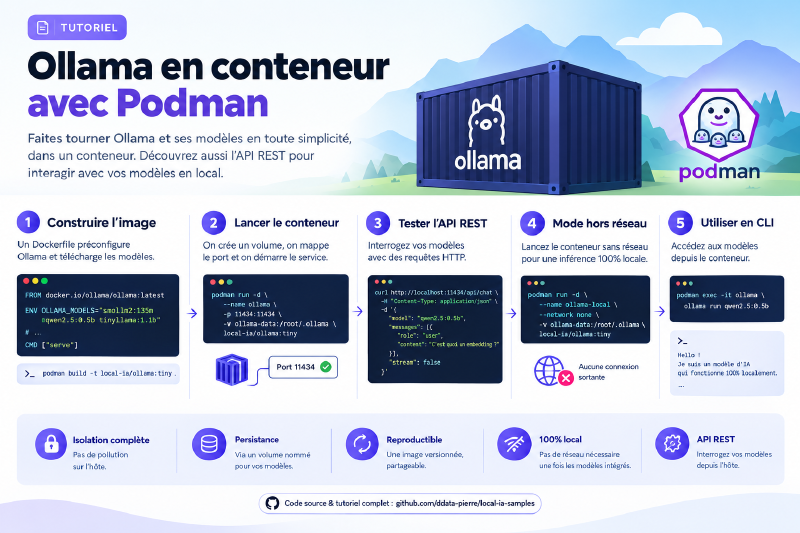
- Déployer et tester un premier moteur d’inférence conteneurisé Ollama exposant une API compatible OpenAI.
Le Socle Système : WSL2 & Podman Rootless#
Pourquoi Podman plutôt que Docker Desktop ? Podman s’intègre nativement avec systemd et les Quadlets, ce qui permet de gérer nos conteneurs d’inférence IA comme de véritables services système utilisateur, légers et sans démon central privilégié.
Prérequis essentiels :#
- Windows 11 avec WSL2 (Ubuntu 22.04 / 24.04 LTS) ou directement sous Linux.
- Podman installé au sein de la distribution WSL2 (
sudo apt install podman). - Allocation mémoire recommandée dans
.wslconfig: au moins 8 Go à 16 Go de RAM alloués à la VM WSL.
Découverte du Tuto 1 : Lancer votre premier LLM local#
Dans le dépôt GitHub associé, le Tuto 1 fournit les scripts shell et les définitions de conteneurs pour :
- Télécharger automatiquement un modèle compact et équilibré (comme Qwen2.5-3B-Instruct en GGUF).
- Démarrer le conteneur d’inférence local en exposant l’API sur le port
11434. - Tester une invite (prompt) via une requête
curllocale.
Accès au Code & Déploiement#
Tout le code source, les fichiers de configuration Podman et les scripts d’initialisation du Tuto 1 sont disponibles sur GitHub : 👉 Repository GitHub : https://github.com/ddata-pierre/local-ia-samples/blob/main/01-ollama/docs/tutoriel.md