Vous avez un SLM qui tourne en local. Maintenant, comment l’embarquer dans un agent métier fiable — celui qui ne vous renvoie pas du texte approximatif mais une structure de données validée que votre code peut exploiter directement ? C’est là qu’intervient Pydantic AI.
Ce que fait ce tuto (en 20 min)#
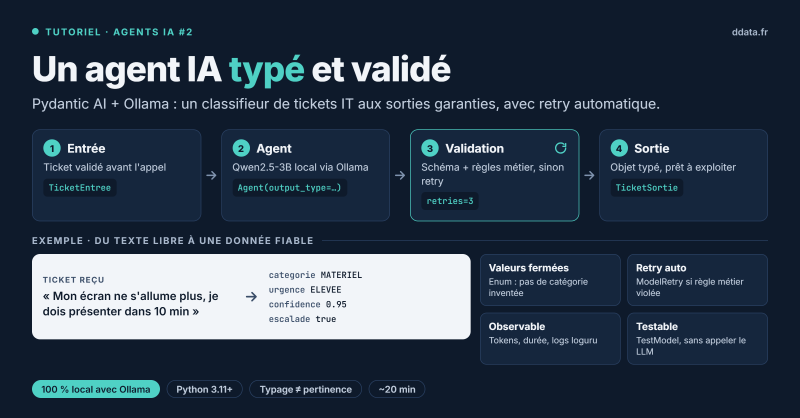
- Installe et configure Pydantic AI avec le backend Ollama (modèle local).
- Définit des modèles Pydantic pour l’entrée (ticket brut) et la sortie (classification structurée).
- Implémente un agent classifieur de tickets IT : catégorie, urgence, résumé, champs techniques — le tout validé à la volée.
- Montre la gestion d’erreurs : retry automatique, fallback, logging structuré.
- Compare avec une approche « prompt brut + parsing manuel » : pourquoi le typage change la donne en production.
Pourquoi Pydantic AI ?#
| Approche classique | Pydantic AI |
|---|---|
Prompt en string, parsing json.loads hasardeux | Schéma Pydantic = contrat explicite |
| Erreur silencieuse → donnée corrompue | Validation automatique, erreur levée propre |
| Retry manuel, logique dispersée | @agent.retry décorateur, politique centralisée |
| Pas de visibilité sur ce que le LLM « comprend » | result.usage() tokens, result.all_messages() historique |
| Test unitaire ? « Marche sur ma machine » | Agent testable, mockable, déterministe (seed) |
Pour qui ?#
Équipes qui ont déjà un SLM local (tuto #1) et veulent industrialiser leurs premiers agents sans réinventer la validation, le retry, l’observabilité. Le typage n’est pas de la paperasse : c’est ce qui permet de chaîner des agents ensuite (Module 3).
Accès au code complet#
👉 Tutoriel pas à pas (GitHub) : 1.2-premier-agent-metier-pydantic-ai/docs/tutoriel.md
Prochain épisode : on donne de la connaissance métier à l’agent — ingestion de documents RH, chunking sémantique, vector DB locale (DuckDB/Qdrant embarqué).