Data Engineering : arrêtez de recalculer ce qui n’a pas changé#
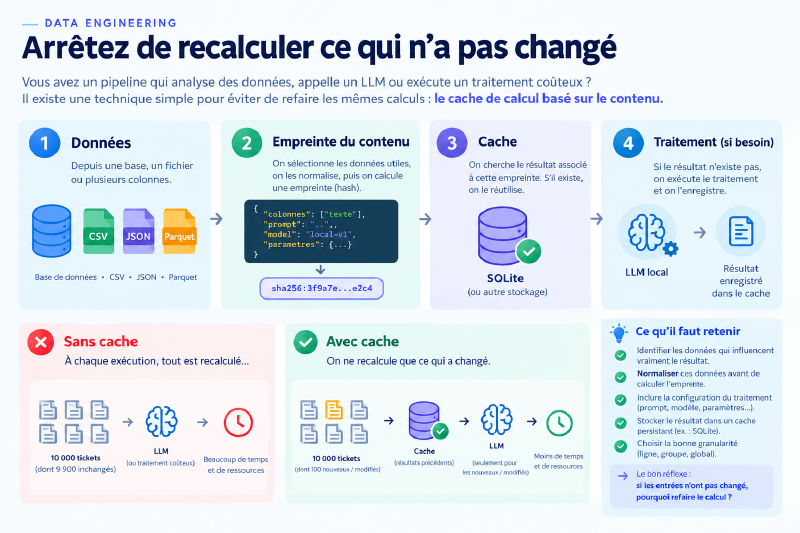
Vous avez un pipeline Python qui analyse des données, appelle un LLM ou exécute un traitement coûteux ? À chaque exécution, il recommence tout, même lorsque les données sont identiques.
Il existe une technique simple pour éviter ça : le cache de calcul basé sur le contenu (content-addressed caching).
Le principe ? Identifier une entrée par son contenu, conserver le résultat associé et le réutiliser tant que rien d’important n’a changé.
Voyons comment l’appliquer concrètement dans un pipeline Data.
Le problème : recalculer pour rien#
Imaginons un pipeline qui analyse des tickets de support avec un LLM local.
Pour chaque ticket, le modèle doit identifier le sujet, le niveau d’urgence et le sentiment du client. Le résultat est ensuite stocké dans une table ou un fichier Parquet.
Votre pipeline traite 10 000 tickets. Le lendemain, vous le relancez pour intégrer les nouveaux tickets.
Mais vous avez toujours 9 900 tickets inchangés.
Pourquoi rappeler le LLM 9 900 fois ?
C’est inutile. Les données analysées sont identiques, le prompt est identique et le modèle n’a pas changé. Dans ce cas, on pourrait simplement réutiliser les résultats précédents.
Et ce problème ne concerne pas uniquement les LLM. Il apparaît partout où un traitement coûteux est répété : enrichissement de données, extraction d’entités, classification, génération de résumés ou calculs métier complexes.
La solution : une empreinte du contenu#
L’idée consiste à calculer une empreinte (hash) des données utilisées par le traitement.
On utilise par exemple SHA-256, un algorithme qui transforme une entrée en une empreinte de taille fixe.
import hashlib
import json

def fingerprint(data):
    payload = json.dumps(
        data,
        sort_keys=True,
        ensure_ascii=False,
        separators=(",", ":"),
        allow_nan=False,
    )
    return hashlib.sha256(
        payload.encode("utf-8")
    ).hexdigest()
Le paramètre sort_keys=True permet de ne pas dépendre de l’ordre des propriétés d’un dictionnaire. Deux objets JSON équivalents, dont les propriétés sont présentées dans un ordre différent, produiront ainsi la même empreinte.
Par exemple :
a = {"ticket": 42, "texte": "Livraison en retard"}
b = {"texte": "Livraison en retard", "ticket": 42}

assert fingerprint(a) == fingerprint(b)
En revanche, si le texte change, l’empreinte change aussi.
C’est exactement ce que nous recherchons : une clé stable pour une entrée identique, une nouvelle clé lorsque l’entrée change.
Attention, ce code est volontairement simple : pour des données issues de Pandas, SQL ou Parquet, il faudra normaliser les types, les dates et les valeurs nulles avant de calculer l’empreinte.
Mettre en place le cache#
Une empreinte seule ne suffit pas. Il faut aussi conserver les résultats déjà calculés.
Le mécanisme est simple :
- Calculer l’empreinte de l’entrée.
- Chercher cette empreinte dans un cache persistant.
- Si le résultat existe, le réutiliser.
- Sinon, exécuter le traitement et enregistrer le résultat.
Pour un pipeline local, SQLite est un excellent point de départ : une base de données dans un fichier, sans serveur à installer.
Voici une implémentation minimale du principe :
import sqlite3
import json

db = sqlite3.connect("cache.sqlite")

db.execute("""
    CREATE TABLE IF NOT EXISTS results (
        cache_key TEXT PRIMARY KEY,
        result TEXT NOT NULL
    )
""")
db.commit()


def get_or_compute(key, compute):
    row = db.execute(
        "SELECT result FROM results WHERE cache_key = ?",
        (key,),
    ).fetchone()

    if row is not None:
        return json.loads(row[0])

    result = compute()

    if result is None:
        raise ValueError("Résultat invalide")

    payload = json.dumps(
        result,
        sort_keys=True,
        ensure_ascii=False,
        allow_nan=False,
    )

    with db:
        db.execute(
            """
            INSERT INTO results(cache_key, result)
            VALUES (?, ?)
            """,
            (key, payload),
        )

    return result
Il ne reste qu’à brancher votre traitement :
ticket = {
    "id": 42,
    "texte": "Livraison en retard",
}

key = fingerprint({
    "texte": ticket["texte"],
    "prompt_version": "classification-v1",
    "model_version": "local-model-v1",
})

result = get_or_compute(
    key,
    lambda: analyser_avec_mon_llm(ticket["texte"]),
)
Lors de la prochaine exécution, si le texte et les versions restent identiques, le LLM ne sera pas sollicité.
Le cache doit être conservé entre les exécutions. Un dictionnaire Python classique ne suffit donc pas si le pipeline redémarre à chaque traitement.
La règle importante : hasher ce qui compte vraiment#
C’est le point qui fait toute la différence entre un cache utile et un cache qui produit des résultats périmés.
Dans l’exemple précédent, nous avons volontairement exclu l’identifiant du ticket de l’empreinte des données analysées.
Pourquoi ? Parce que le LLM ne reçoit que le texte. Si deux tickets contiennent le même texte et utilisent exactement la même configuration, leur analyse peut être réutilisée.
En revanche, si le traitement dépend de plusieurs colonnes, elles doivent toutes entrer dans la clé.
Et si le prompt change, la clé doit changer également.
Une clé robuste inclut donc généralement :
- Les données réellement utilisées par le traitement.
- La version du prompt et du code d’analyse.
- L’identité précise du modèle utilisé.
- Les paramètres susceptibles d’influencer le résultat.
Ne vous contentez pas de hasher le fichier source. Deux fichiers Parquet peuvent contenir les mêmes données logiques tout en ayant des octets différents à cause de la compression ou des métadonnées. À l’inverse, un fichier peut changer sur une colonne que votre analyse n’utilise même pas.
Le bon réflexe consiste à sélectionner les champs nécessaires, à les normaliser, puis à calculer l’empreinte de cette représentation.
À quelle granularité appliquer le cache ?#
Il y a trois cas classiques.
| Type de traitement | Granularité du cache |
|---|---|
| Analyse indépendante de chaque ticket | Une clé par ticket ou par contenu analysé |
| Analyse d’un groupe de tickets | Une clé par groupe |
| Résumé global de tous les tickets | Une clé pour l’ensemble des données utilisées |
Dans la plupart des pipelines d’enrichissement, le cache par ligne est particulièrement intéressant. Si un seul ticket change, on ne recalcule que son analyse.
En revanche, si votre LLM reçoit 500 tickets pour produire un résumé global, modifier un seul ticket peut nécessiter de recalculer ce résumé.
Il faut donc choisir la granularité en fonction des dépendances réelles du traitement, pas uniquement en fonction du format des données.
Les limites à connaître#
Quelques précautions évitent les mauvaises surprises.
Les types doivent être normalisés. Une date, un décimal, une valeur nulle ou un NaN ne doivent pas être sérialisés de manière ambiguë. Définissez une représentation canonique adaptée à vos données.
Un résultat mis en cache doit être valide. N’enregistrez pas une réponse LLM incomplète ou qui ne respecte pas le schéma attendu. Pour un résultat valide mais vide, prévoyez une représentation explicite afin de le distinguer d’une absence de cache.
Un changement de modèle doit être détecté. Un simple nom de modèle ne suffit pas toujours. Idéalement, utilisez son identifiant immuable ou l’empreinte de ses poids, ainsi que les paramètres d’inférence pertinents.
Enfin, ce mécanisme garantit la réutilisation d’un résultat pour une clé donnée. Il ne garantit pas, à lui seul, que deux exécutions indépendantes d’un LLM produiront exactement la même réponse.
En résumé#
Le cache basé sur le contenu est une technique simple, mais particulièrement efficace dès qu’un pipeline répète des calculs coûteux.
Pour commencer :
- Identifiez un traitement qui consomme du temps ou des ressources.
- Déterminez précisément quelles données influencent son résultat.
- Calculez une empreinte stable de ces données et de la configuration.
- Stockez le résultat dans un cache persistant, par exemple SQLite.
- Réutilisez le résultat tant que la clé existe et reste valide.
Pas besoin de déployer une nouvelle plateforme ou d’ajouter une architecture complexe. Quelques fonctions Python et une base SQLite peuvent suffire pour un premier cas d’usage.
Le principe à retenir est simple : si les entrées d’un calcul n’ont pas changé, pourquoi le refaire ?
C’est une application très concrète des principes KISS et DRY : moins de calculs inutiles, moins de coûts et des pipelines plus efficaces.