Data Contracts #2 : Où les placer et comment les déployer sans tout casser#
Dans le premier article, nous avons vu ce qu’est un Data Contract sous le standard ouvert ODCS. Mais une fois le concept compris, une question essentielle se pose sur le terrain : où doit-on concrètement placer ces contrats dans notre pipeline, et par quoi commencer sans paralyser les équipes ?
Si vous essayez d’imposer des contrats sur l’intégralité de vos données du jour au lendemain, vous vous heurterez à un rejet massif. Voici les bonnes pratiques d’architecture et la stratégie d’implémentation progressive pour réussir.
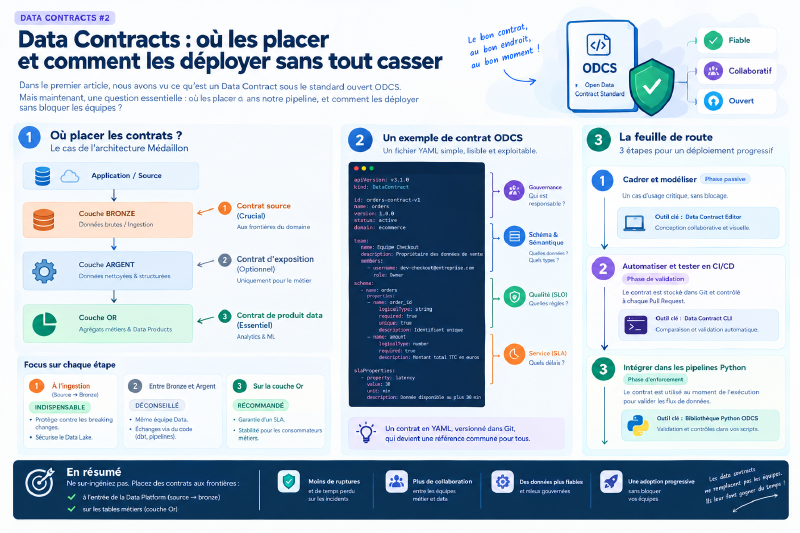
Où placer les contrats ? Le cas de l’architecture Médaillon#
L’architecture Médaillon (Bronze / Argent / Or) est aujourd’hui un standard dans les Data Lakes et Lakehouses. Faut-il mettre des contrats à chaque niveau ?
 [ Application / Source ]
            │
            ▼  ◄─── 1. CONTRAT SOURCE (Crucial : aux frontières du domaine)
   ┌─────────────────┐
   │  Couche BRONZE  │  (Données brutes / Ingestion)
   └─────────────────┘
            │
            ▼  ◄─── 2. CONTRAT D'EXPOSITION (Optionnel : uniquement pour le métier)
   ┌─────────────────┐
   │  Couche ARGENT  │  (Données nettoyées & structurées)
   └─────────────────┘
            │
            ▼  ◄─── 3. CONTRAT DE PRODUIT DATA (Essentiel : Analytics & ML)
   ┌─────────────────┐
   │    Couche OR    │  (Agrégats métiers & Data Products)
   └─────────────────┘
1. À l’ingestion (Source ➔ Bronze) : INDISPENSABLE#
C’est le contrat le plus critique. Il se place à la frontière entre le système producteur (l’application) et la plateforme Data.
- Pourquoi ? C’est ici que surviennent les breaking changes (changement de schéma en base de prod). Ce contrat protège le Data Lake de la pollution amont.
2. Entre Bronze et Argent : DÉCONSEILLÉ#
La couche Bronze stocke l’historique brut, et la couche Argent nettoie la donnée en interne.
- Pourquoi ? Mettre un contrat ici alourdit l’architecture pour rien. Ce sont deux couches gérées par la même équipe Data : les échanges se font via du code (modèles dbt, pipelines), pas besoin d’un contrat formel d’interface.
3. Sur la couche Or (Data Products) : RECOMMANDÉ#
La couche Or expose les données prêtes à l’emploi pour les consommateurs métiers, les Data Scientists ou la BI.
- Pourquoi ? Le contrat sert d’accord de niveau de service (SLA). Il garantit au métier que la table de chiffre d’affaires ne changera pas de structure sans préavis.
La feuille de route : 3 étapes pour déployer sans friction#
Pour réussir l’adoption, la clé est la progressivité. On passe d’une observation passive à une automatisation stricte en trois temps.
Étape 1 : Cadrer et modéliser (Phase Passive)#
On commence sur un seul cas d’usage critique (ex: les événements de vente). On ne bloque rien en production, on cherche juste à aligner le métier et les développeurs sur une définition commune.
- L’outil clé : Data Contract Editor Pas besoin de manipuler du code. Cet éditeur visuel en ligne permet de concevoir le contrat de manière collaborative lors de réunions de cadrage. On exporte ensuite le fichier ODCS généré.
Étape 2 : Automatiser et tester en CI/CD (Phase de Validation)#
Une fois le contrat validé, on le stocke dans le dépôt Git du projet. On active ensuite des contrôles automatiques lors des modifications de code (Pull Requests).
- L’outil clé : Data Contract CLI (
datacontract-cli) C’est le couteau suisse en ligne de commande. Il s’intègre dans vos pipelines CI/CD (GitHub Actions, GitLab CI) pour comparer la base de données réelle avec le contrat ODCS. Si un développeur supprime une colonne obligatoire, la CI échoue avant le déploiement.
Étape 3 : Intégrer dans les pipelines Python (Phase d’Enforcement)#
Enfin, lors de l’exécution des pipelines d’ingestion ou de transformation, le contrat est utilisé dynamiquement pour valider les flux de données entrants.
- L’outil clé : La bibliothèque Python ODCS (
open-data-contract-standard) Elle permet aux Data Engineers de charger et parser le contrat ODCS directement dans leurs scripts Python, Airflow ou Dagster, afin de dériver automatiquement des contrôles de qualité au moment de l’exécution.
En résumé#
- Ne sur-ingéniez pas : Placez des contrats aux frontières (à l’entrée de la Data Platform et sur les tables métiers finales), pas entre vos tables intermédiaires.
- Appuyez-vous sur l’écosystème : L’outillage ODCS existe déjà (Éditeur visuel pour concevoir, CLI pour valider en CI/CD, Python pour exécuter).
- Avancez pas à pas : Un seul contrat respecté à l’ingestion apporte plus de valeur que dix contrats théoriques oubliés dans un dossier.